大模型
浙江发布"医疗Token工厂"推进医学人工智能产业化
浙江在第五届全球数字贸易博览会上正式发布"医疗Token工厂"1.0版本,这一医疗AI核心基础设施由国家人工智能应用中试基地(医疗)·浙江、浙江省数据集团、蚂蚁集团、浙江省安诊儿公司四方联合打造。该工厂通过统一的Token机制打通医疗智能资源的流通通道,旨在破解医疗AI产业化中数据安全、模型调用、能力标准化等核心痛点…
深圳AI新政征求意见,"模型券"升级为"词元券"
深圳市工业和信息化局正在修订《打造人工智能先锋城市的若干措施》,对现有政策工具包进行优化升级 。现行措施自2024年12月18日起施行,有效期为2年,今年底即将到期 。此次修订将新增推动场景应用联合攻关和行业赋能平台建设政策,并突出支持OPC社区发展 。
前沿语言模型物理能力被严重低估 专家重新评分揭示基准测试缺陷
研究人员通过专家重新评分发现,前沿语言模型在物理基准测试上的报告分数存在重大偏差。经过审计和纠正,GPT-5.6-Sol在HLE-Physics基准上的评分从47.3%大幅上升至78.7%,在CMT-Benchmark上从61.0%上升至87.2%,表明当前物理基准测试严重低估了这些模型的实际能力。
AI当"科研搭子",你真的放心吗?
中国农业大学、北京大学等科研机构已将人工智能融入科研工作的多个环节,包括选题、实验规划和论文撰写,但这一应用趋势也暴露出诸多风险。在选题阶段,虽然AI能批量生成候选研究问题——中国农业大学朱晨系统生成的79个候选研究问题中87%符合基本条件——但研究表明这些选题多停留在初级水平,无法提出具有原始创新性的问题。在实验分…
华为监事会主席郭平:目标成为英伟达,虚心学习苹果供应链
华为监事会主席郭平近日与新员工座谈,阐述了公司的战略方向与业务规划。郭平表示,华为在ICT及计算领域的目标是成为英伟达。

通用大模型难适配新型电力系统,定制化AI成发展方向
通用大模型在适应新型电力系统的物理约束方面存在明显短板,专用的混合架构大模型成为必要选择。我国能源结构正在加速调整,国家能源局数据显示,截至7月底,光伏装机容量首次超过煤电,占全国装机的31.5%。光伏发电已深度融入社会用电,全国每8度电中就有超过1度来自光伏,占全社会用电量的13%。
大模型厂商纷纷入驻天猫,Token订阅服务向电商平台扩展
国内多家大模型厂商正在将订阅服务拓展至传统电商渠道。智谱于9月2日正式入驻天猫,开设"智谱旗舰店",上架基于GLM-5.3模型的GLM Coding Plan订阅套餐。同时,Kimi、MiniMax、阶跃星辰等厂商也在与天猫接洽中,未来将陆续入驻开设官方旗舰店。

打开“智治”的盒子:AI政务的城市方法论
南方周末城市(区域)研究中心发布报告,系统梳理人工智能大模型在中国地方政府政务领域的应用现状,涵盖政务服务、机关办公、社会治理、辅助决策四大场景。报告指出政务AI呈现明显梯度分化,头部城市及主城区领跑,同时暴露区域失衡、基层运维薄弱、人才短缺、制度滞后及公众参与缺失等问题,并提出集约化部署、省级底座复用、人机协同与参…

数据赋能 “数据要素×”大赛广东分赛福田赛站决赛启幕
2025年8月25日,2026年“数据要素×”大赛广东分赛福田赛站决赛开赛仪式在粤港澳大湾区大数据中心举行 。本次大赛共吸引超1800个项目申报,最终入围决赛的团队超400个 。福田区承办金融服务、应急管理、绿色低碳三大赛道,参赛队伍将在未来三天展开角逐 。
imageat 平台推出 Qwen 3.8 27B Uncensored 托管 Chat API
imageat 平台将 Qwen 3.8 27B Uncensored 模型封装为托管式 Chat API,开发者无需下载模型或规划 GPU,即可通过 OpenAI 兼容接口进行调用 。该模型支持 262,144 个 token 的上下文预算,并提供可选的 thinking 模式,适用于长文档分析、代码审查和研究笔记…
GLM-5.3-Flash
智谱AI正式发布了GLM-5.3-Flash大模型,相关信息在Hacker News上引发关注。根据Artificial Analysis的报告,该模型由Z AI于2026年8月26日推出。GLM-5.3-Flash是一款闭源推理模型,采用扩展思维或思维链推理,且Z AI未披露其参数规模。此外,该模型仅支持文本输入和…
物理AI开发者正努力突破“GPT-2时代”瓶颈
在经历Unitree等公司估值大幅波动后,物理AI领域的开发者正面临高质量训练数据短缺的瓶颈 。Unitree的估值在达到660亿美元后,于本周下跌了近一半 。目前,整个行业被认为处于类似GPT-2的阶段 。在Actuate会议上,参会规模较2023年扩大了三倍,达到1500人 。
行为指纹分析揭示匿名模型Ox Alpha或源自GLM-5系列
2025年8月20日,匿名模型Ox Alpha上线OpenRouter平台,其页面标注该模型“由第三方模型提供商开发和运营”。为探究其真实来源,LineageEval研究团队利用审查测试和分词器匹配分析对其进行了行为指纹溯源,结果表明Ox Alpha的行为特征与GLM-5系列高度吻合。
OpenAI大幅降价GPT-5.6系列,Luna价格跌至0.2美元创新低
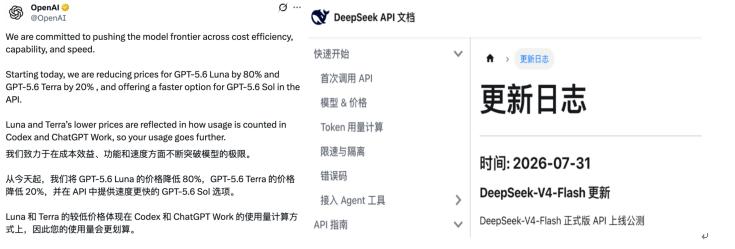
OpenAI于7月31日宣布GPT-5.6系列模型大幅降价。其中Luna模型降幅最大,输入价格从1美元下降至0.2美元,输出价格从6美元降至1.2美元,总体降幅达80%。这一定价已经低于DeepSeek V4 Pro的0.435美元/百万Token。Terra模型的输入价格也从2.5美元降至2美元,输出从15美元降至…
DeepSeek-V4-Flash正式版API上线公测
DeepSeek于7月31日宣布DeepSeek-V4-Flash正式版API上线公测。该版本在多项Agent基准测试中表现出色,Terminal Bench 2.1达到82.7分,NL2Repo得分54.2分,Cybergym达到76.7分,DSBench-FullStack为68.7分,DSBench-Hard为…
Token浪潮起:AI再造千亿商业版图
中国大模型产业正经历Token(词元)从技术参数向交易资产的转变。中国日均Token调用量在两年内实现了惊人增长,从2024年初的1000亿激增至2026年3月的140万亿,增幅达千倍。这一爆发式增长反映了AI模型应用的快速扩张,也推动了围绕词元的新型商业生态形成。

华为开源盘古 openPangu-2.0-Pro 大模型及技术报告
华为官宣开源盘古 openPangu-2.0-Pro 模型及技术报告。该模型参数规模约 505B,每 token 激活参数规模约 18B,基于昇腾 NPU 训练,支持 512k 上下文长度。训练数据总量约 34T tokens。模型在 Attention 架构、拓扑架构、自投机模块等方面进行了全面升级。
OpenAI宣布GPT-5.6系列模型大幅降价
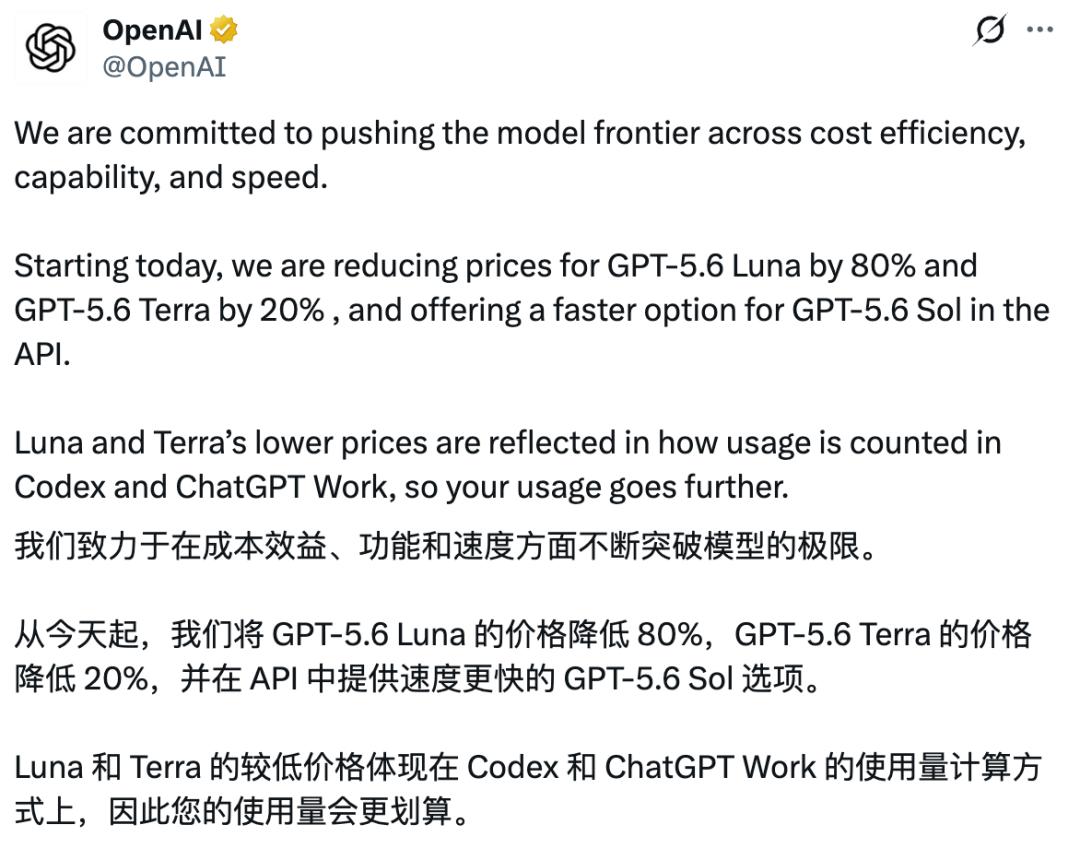
OpenAI推出了GPT-5.6系列模型的价格调整方案 。其中,入门款Luna大幅降价80%,输入价格从1美元/百万Token降至0.2美元/百万Token,输出价格从6美元/百万Token降至1.2美元/百万Token 。中端型号Terra降价20%,输入和输出价格分别为2美元/百万Token和12美元/百万Tok…

AI教父失去了AI时代
曾被誉为"AI教父"的李开复创办的零一万物,正经历战略转向。该公司在2025年1月成为首家宣布放弃训练超级大模型的模型公司,标志着这家初创企业在大模型竞争中的策略调整。李开复随后表示,"大模型已经不适合创业公司,只有大公司能继续做"。
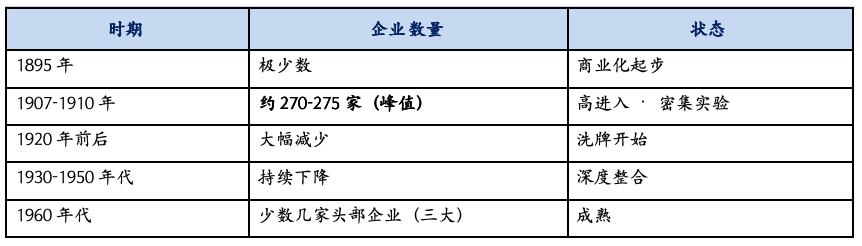
AI产业演化的时间尺度:所处阶段与未来节奏
腾讯研究院发布的产业演化分析报告认为,当前AI大模型及其应用产业处于"分化带"——一个从晚期流动期向早期过渡期移动的过渡阶段。在这一阶段,产品分层仍保持开放性,但企业能力分化已经启动。
大模型巨头陷入内卷困局:资本开支巨大却领先窗口被压缩至月级
尽管投入巨大,大模型产业的技术差距已趋于微小,竞争优势转瞬即逝。根据斯坦福AI Index 2026报告,LMArena前四模型的Elo分差不到25分,在税务、金融、法律等测试中前15名模型的差距最小仅为3个百分点。这种技术的快速同质化直接导致排名的频繁变动——过去39个月,LMArena榜首易主21次,平均在位时间…
多空头激辩:AI当前的核心争议,以及赢家和输家
华尔街分析师围绕人工智能产业的资本回报率、大模型护城河和软件行业分化等问题展开了激烈辩论。讨论认为AI产业已创造超1000亿美元的年化变现收入,产业价值正从模型本身向算力与数据生态转移。

月之暗面完成35亿美元融资,估值冲刺350亿美元
大模型公司月之暗面在最新融资轮中筹集35亿美元,大幅超过原定的10至20亿美元融资目标 。融资后公司估值达到350亿美元,投前估值为315亿美元 。这笔融资由国家人工智能产业投资基金领投 ,参与方包括龙珠资本、中国移动、清华资本、中金公司和高盛集团 。
被骂了十年的智能客服,这次能听懂人话了吗?
智能客服长期因技术不成熟而饱受诟病,但这一局面正在改变。随着大模型应用的推进,AI客服开始具备理解上下文、调用工具、处理复杂任务的能力,从单纯的问答系统向完整的服务流程升级。不过用户的不满情绪仍在高涨——2024年全国消费者投诉中智能客服相关投诉达6969件,同比增长56.3%。
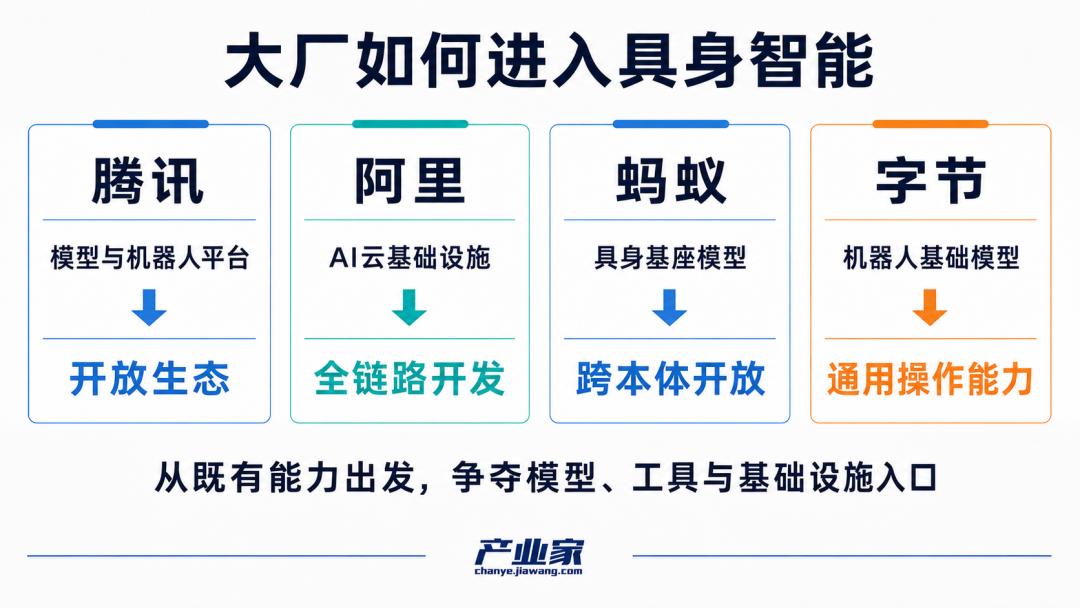
大厂独角兽争夺具身智能"大脑"
具身智能产业中的核心技术竞争正在升温。蚂蚁集团旗下蚂蚁灵波科技于7月8日宣布全面开源具身基座模型LingBot-VLA 2.0,腾讯同步开源混元3D世界模型2.0,阿里则与英伟达在Physical AI领域达成合作。大厂通过开源具身基座模型、VLA模型等方式,试图建立数据-模型-部署的闭环。与此同时,独角兽企业也在积…
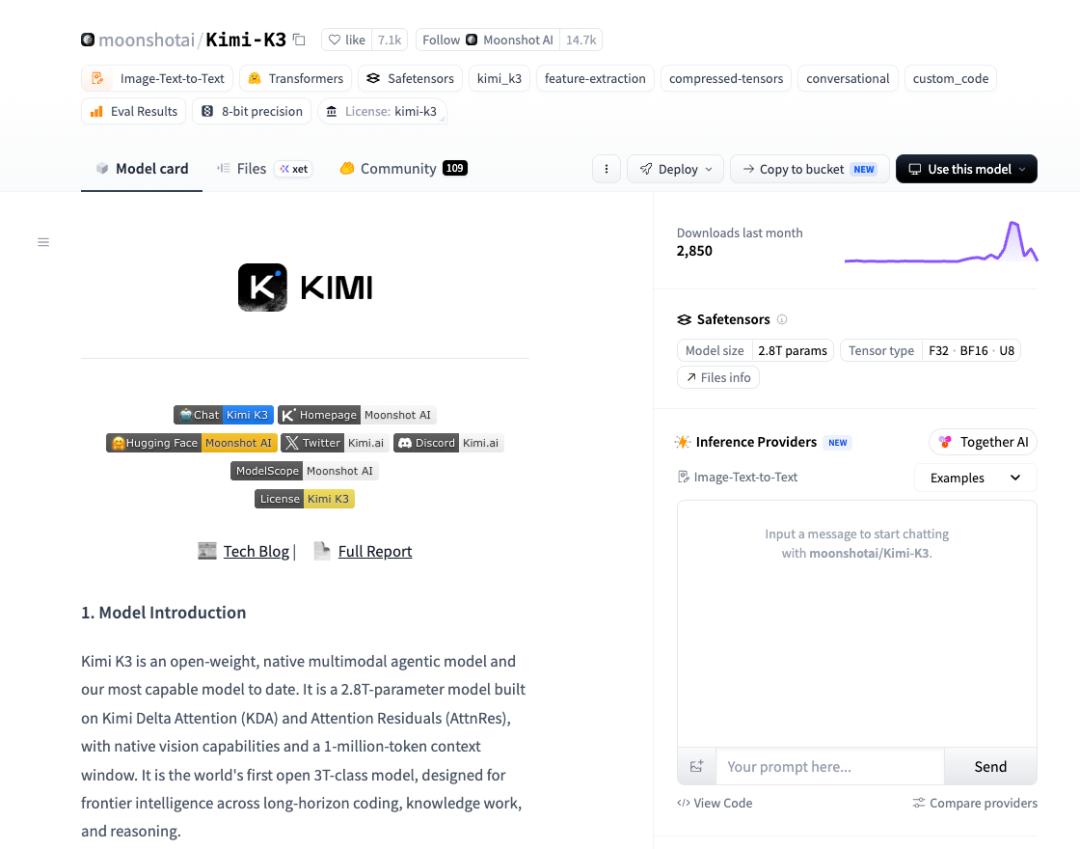
Kimi K3正式开源,跻身全球第三梯队
Kimi K3大模型已在Hugging Face平台正式开源,并附带详细技术报告和训练工具。该模型总参数达2.8T,其中激活参数为1042亿,是DeepSeek V4 Pro激活参数的两倍。在全球主流跑分测试中,Kimi K3仅低于Fable 5和GPT-5.6 Sol,排名第三,并是TOP3中唯一可本地运行的开源模…
Claude Opus 5发布,性能大幅提升价格保持不变
Anthropic推出了Claude Opus 5大模型。新模型相比前代Opus 4.8实现了显著的性能提升,同时维持原有价格——输入令牌$5/百万,输出令牌$25/百万。
月之暗面发布Kimi K3引发硅谷震动,创始人杨植麟身份引关注
中国AI公司月之暗面推出新一代大模型Kimi K3,配置2.8万亿参数和100万Token上下文窗口。该产品发布后72小时内,美股AI板块合计蒸发约4700亿美元,其中智谱AI股价在两个交易日内累计暴跌超42%,市值蒸发超3000亿港元。
Gemini最新模型弃用采样参数
Google发布了Gemini 3.6 Flash和Gemini 3.5 Flash-Lite两款新模型,现已正式可用 。
Laguna S 2.1
Poolside发布了Laguna S 2.1模型,这是一个118B总参数的混合专家模型,其中8B参数在推理时处于激活状态,支持100万token的上下文窗口 。该模型从训练开始到发布仅耗时不到9周 。

首尔 ICML 四天:模型吃掉一切的速度,快过所有人找身位的速度
在 ICML 2026 期间的首尔观察中,与会者目睹了当前 AI 产业与学术界的几大核心转变 。