Gpu优化
科技人工智能
Mini-AGI:8GB显存下的连续学习模型
Mini-AGI是一个开源字节级连续学习语言模型,可在单块8GB显存的GPU上从零开始训练。该项目通过将权重存储在磁盘上并按需调入显存的方式突破了显存限制,使个人PC或笔记本用户能够进行无限继续学习。
科技人工智能
ShapeLearn发布Qwen 3.8 27B完整量化版本,性能达BF16基准99.63%
ShapeLearn团队发布了Qwen 3.8 27B模型的完整量化版本,相比此前的ShapeLearn-Lite版本提升了性能表现。该完整版本包含五个不同量化级别的模型,在6种GPU配置下的测试中均实现了质量与速度的帕累托最优。
科技人工智能
开发者以998美元训练3.8B参数模型,性能超越GPT-2
Hugo Vergnes利用开源框架little-lm在NVIDIA B200 GPU上训练了一个包含3.8B参数的大语言模型,项目耗资仅998美元,完成时间为43小时。该模型在CORE基准上获得0.384分,超过了GPT-2 1.5B模型的0.2565分。
科技人工智能
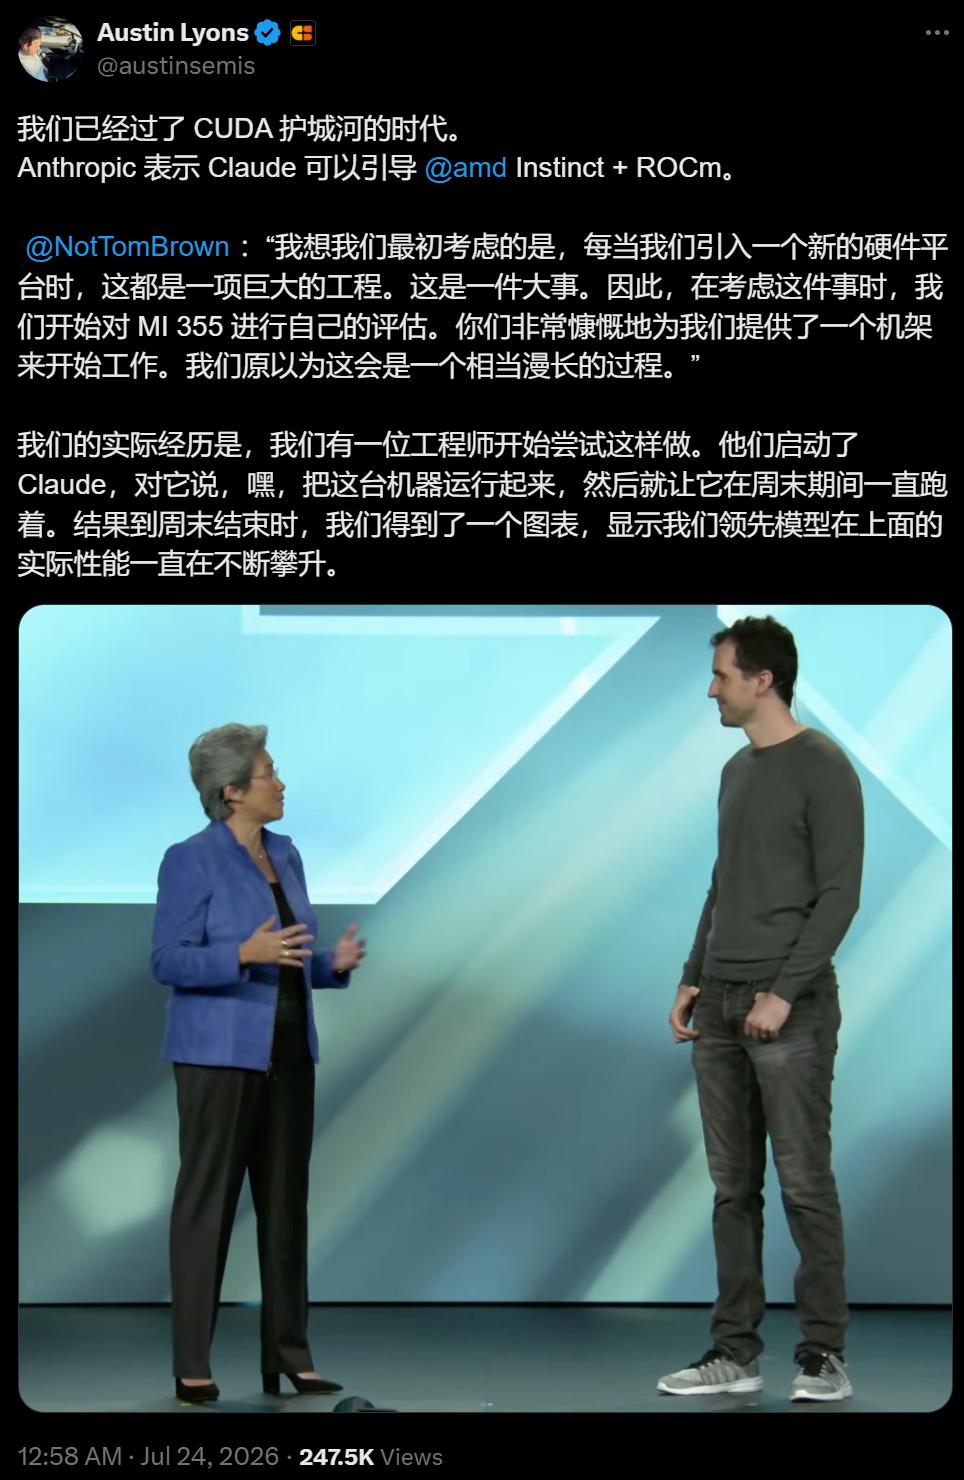
CUDA 20年护城河一个周末崩了,Claude独自跑通AMD新GPU
Anthropic的AI助手Claude在一个周末内独立调通了AMD新型GPU MI355X,全程未经工程师手动修改代码。这一突破背后是AMD新发布的ROCm.AI工具套件,该套件配备AMD Skills和AI可读的ISA指令集,使得AI Agent能够自主读取芯片文档、优化工作负载。AMD同步将芯片说明书改写为AI…